Заметки: ИИ

Мои мысли о жизни, работе и разных интересных штуках вокруг меня.

Показано: 0 · Страница

Феномен Егоровой
22 августа 2026 ·

Последние полгода постоянно использую Whisper для расшифровки встреч. Заметил забавный эффект: чем толще модель, тем лучше она распознаёт речь и тем увереннее несёт бред там, где речи нет.

Например, такое бывает в начале вебинара или встречи, пока участники собираются. Тихо, все молчат, разве что кто-нибудь шумно тянет кофе. И Whisper внезапно начинает выдавать что-то такое:

Редактор субтитров А.Синецкая Корректор А.Егорова

И что хуже, продолжает выдавать это даже тогда, когда начинается уже вполне разборчивая речь.

Это здорово раздражало, так что пришлось разобраться.
Да кто такая эта ваша Егорова

Почему тишина так распознается?

Под капотом у Whisper — мощная языковая модель, которая пытается подобрать наиболее вероятный текст с учётом аудио и уже распознанного контекста. В общем случае это работает как надо: модель хорошо понимает речь, контекст, имена и сложные фразы.

Но если на входе тишина, шум или что-то невнятное, звук почти перестаёт быть ей полезен. И вот тут модель начинает гадать: какой текст здесь вообще мог бы быть, хм? Обучена она на гигантском датасете аудио с текстовыми расшифровками, которые OpenAI натаскала со всего интернета (порядка 700 тысяч часов, если не путаю).

Среди этого добра, полагаю, было полным-полно видео с субтитрами — а это штука такая, грязная. Во время тишины в сабах вполне может мелькать имя переводчика, редактора, название студии, «спасибо за просмотр» и прочий мусор, которого в аудио вообще нет.

Вот так, думаю, Синецкая с Егоровой и вошли в историю. Над чем они работали, я найти не смог, но, видимо, надпись с отсылкой на них маячила в сабах достаточно часто, чтобы Whisper поставил знак равенства между ними и тишиной.

Почему так распознаётся не только тишина?

Угу, если бы всего лишь получали шум во время пауз, это вообще не было бы проблемой: мусорный фрагмент текста известен и его можно просто выкидывать из выдачи. Хуже всего тут то, что ошибка распознавания портит контекст модели — упрощая, Whisper распознаёт тишину как Егорову, подсовывает этот результат себе же как контекст следующего куска и едет дальше с этим знанием.

Следующий кусок, допустим, опять Егорова, и потом тоже, и потом... Когда спикер наконец-то начинает говорить, ему нужно начать ОЧЕНЬ внятно, чтобы модель согласилась, что да, это уже речь, а не Егорова, набравшая силу на двадцати кусках до него. В результате модель способна застрять в этом состоянии очень надолго.

Проблеме сто лет (ну ладно, четыре года) и она существует для множества языков. Русский, кстати, выбивается из общего ряда — если итальянцы, французы и испанцы видят скучное «Субтитры созданы сообществом Amara.org», то у нас, так сказать, свой фэндом.

Как бороться?

Вообще считается, что надо тюнить инференс: сбрасывать контекст после длинных пауз, играться с no_speech_threshold, condition_on_previous_text, предварительно отрезать тишину с помощью VAD и так далее. До VAD я не добрался, но остальные варианты пробовал — действительно можно добиться вполне сносного результата на конкретном проблемном видео.

Однако мне этот вариант не подошел: мне нужно распознавать самые разные видео — записи встреч, лекции, телефонные разговоры, что угодно. Комбинация приёмов, подобранная для одного видео, не работает для другого. Из инженерного азарта я пробовал собирать обвязку в духе «прогнать видео через три разные комбинации приёмов, а потом проанализировать результат и выбрать тот, где концентрация Егоровой пожиже», но это всё равно работало так себе.

Так что я выбрал другое решение: использовать модель поглупее!

Серьёзно, это работает. По крайней мере на моих видео Whisper Small сваливается в repetition loop на тишине сильно реже. Видимо, более слабой модели сложнее уверенно вывести мусорный паттерн, поэтому на тишине она просто не выводит ничего.

Упрощая,

  • Whisper Small: Эээ... Ничего не слышу. Непонятно.
  • Whisper Medium: Эээ... Ничего не слышу... (напрягает свои параметры) А! Знаю! (вступают фанфары) Это ж Егорова!

:D Горе от ума, буквально.

Качество расшифровки у Whisper Small получается, конечно, пониже — больше криво распознанных слов, менее связно, но это лучше, чем когда треть звука слопано Синецкой, а остальное поглодала Егорова результат в среднем более предсказуем.

Кроме того, его все равно нужно потом загнать в условный ChatGPT, чтобы собрать саммари, а для этого гигачада восстановить контекст диалога вообще не вопрос, даже если фрагменты реплик потеряны.
Мику-питомец для Codex
18 августа 2026 ·

В десктопном Codex есть питомцы — пиксельные персонажи, которые рендерятся поверх UI и показывают, чем занят агент: работает — идёт, ждёт ответа — зовёт пользователя, застрял — жмурится и так далее. Общая идея в том, что пользователь запускает какой-нибудь флоу, переключается на свои дела и краем глаза видит, как там всё идёт.

Фича не особенно полезная, но забавная. Правда, встроенные питомцы мне не зашли; полез смотреть работы сообщества и внезапно на ровном месте разогнался сделать своего — на базе дизайна Хацуне Мику из Miku'n POP, старого-престарого платформера.

Оказалось, не особенно сложно. Спрайты я взял из MikuPet (автор использует тот же дизайн из Miku'n POP), а формат самого питомца довольно понятный (да и благодаря тому же Codex копаться в нём особо не пришлось). Дольше разбирался, чей там арт, на каких условиях его можно переиспользовать и так далее.

Питомца можно скачать с GitHub, там же скриншот и подробные описания того, что внутри барабанчика.

Бесплатный бонус: сборщик релизов в таком проекте можно назвать «Release pet» :)

Obsidian Property Organizer
9 августа 2026 ·

Что точно стало лучше с появлением ИИ в инструментарии разработчиков — наконец-то появилась реальная возможность доделывать мелкие проекты. Я про всякие тулкиты, MVP-шки и идеи, которые раньше почти всегда отправлялись в стол: делать вроде хочется, но тратить несколько вечеров на очередную маленькую утилиту просто-напросто влом.

Например, на прошлой неделе я навайбкодил себе плагин для Obsidian, который приводит в порядок свойства заметок. Если вкратце: для разных папок можно задать, какие свойства должны быть у заметок и в каком порядке. Плагин добавляет недостающие, убирает лишние и переставляет всё как положено — вместо того бардака, который я когда-то накидал на скорую руку и забыл поправить.

В репозитории на Github есть подробное описание, как это работает.

Вроде бы мелочь, да? Поглаживание внутреннего перфекциониста. Но мне нравится порядок, а за три дня плагин успели скачать семьдесят человек.

Привет вам, собратья по навязчивой любви к чистоте :)

Если кто-то его создаст
28 июня 2026 ·

В Corpus вышла на русском языке книга «Если кто-то его создаст — все погибнут» Элиезера Юдковского и Нейта Соареса. Оба — известные исследователи в области безопасности ИИ, AI alignment и рисков сверхинтеллекта.

В книжке авторы внятно и последовательно объясняют, почему её название — не истерика, не преувеличение и не байт на лайки. Тезис простой и неприятный: если кто-нибудь на планете действительно создаст AGI или ASI на технологиях, близких к нынешним — человечеству хана.

Соареса я раньше не читал, а вот в Юдковском всегда сочетались два редких качества: экспертность в теме и способность рассуждать о ней человеческим языком, не проваливаясь в заумь каждые тридцать секунд. То есть вам не обязательно иметь профильный бэкграунд: тут явно проделана куча работы просто для того, чтобы текст был понятен аудитории без кандидатской по прикладной математике.

Короче, книжка классная. Забыл уже, когда в последний раз читал что-то запоем, на одном дыхании. Есть на Озоне, в Читай-городе, есть даже в пиратских бухтах (осуждаю, но если ваш фрегат с черным флагом уже припаркован у подъезда, то что я могу поделать) :)

Автосаммари
8 февраля 2026 ·

Записывать все встречи я, судя по моим же заметкам, начал ещё в 2020-м. Видео всегда точнее памяти, а ткнуть на «Start Recording» в OBS — самый дешёвый способ не потерять какую-нибудь ценную инфу.

Минусы, впрочем, очевидны — с видео нельзя быстро ухватить суть встречи, по нему невозможен быстрый поиск, оно много весит, в нём легко засветить что-то личное и так далее. Чтобы частично компенсировать это, я в течение встреч тезисно помечал ключевые моменты, а потом либо перекидывал в задачник, либо делал себе что-то вроде саммари: с кем встречался, что обсуждали, какие решения подобрали. Если что-то забыл или упустил детали — сверялся с видео.

Однако этот метод тоже не идеален. Создание конспекта (даже тезисного) отъедает фокус от самой встречи. Кроме того, про какие-нибудь забытые по ходу дела подробности можно узнать слишком поздно.

Забыл

Короче, пришёл к тому, что хороший вариант — просто извлекать из видео аудио разговора, превращать его в текст (нейронкой), а текст разговора — в детальное саммари по встрече (опять нейронка).

Аудио проще всего выдрать через ffmpeg (консольная утилита для работы с аудио и видео). Ниже пример вызова (один аудиоканал, дискретизация 16 кГц + нормализация громкости):

ffmpeg.exe -y -i "D:\video.mkv" -vn -ac 1 -ar 16000 -af loudnorm -c:a pcm_s16le "D:\audio.wav"

Что до извлечения текста — я экспериментировал с Vosk в связке с recasepunc, но про это без слёз не вспомнить. Даже комментировать не хочу. А вот Боромир Whisper (нейросеть от OpenAI, умеющая распознавать голос) ставится в фоне за 10 минут:

py -3.10 -m venv .venv
.\.venv\Scripts\Activate.ps1
pip install setuptools wheel
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
pip install openai-whisper

Пример вызова:

whisper "D:\audio.wav" --model small --language Russian --output_format txt

На выходе получится текстовый файл с расшифровкой, который можно запихать в любой чатбот и получить вполне связное саммари. Его, конечно, всё ещё нужно вычитать — убрать ошибки и фантазии, что-то переформулировать — но это всё ещё сильно лучше создания конспекта на ходу.

Вот, в общем-то, и весь метод. Остаётся написать простой скрипт, чтобы не дергать две команды вручную. Если вы тоже на Windows и вам лень вайбкодить, можете взять мой скрипт и подогнать под себя.

Скрипт ищет в своей папке первый попавшийся .mkv, прогоняет через ffmpeg + Whisper и сохраняет результат в ту же папку. Если будете использовать — обратите внимание, что он работает через CUDA (на CPU тоже можно, но будет сильно медленнее) + скачанные модели Whisper он сохраняет не в дефолтный кэш, а в папку с текущим Python-окружением.

(при желании можно прикрутить к нему вызов API или обращение к какой-нибудь модели в локальной LM Studio, но персонально для себя я решил — не, уже перебор)

Смутно знакомый логотип
14 декабря 2024 ·

Тем временем OpenAI открыл в Тбилиси филиал На самом деле тут вейпами торгуют, а дизайнер логотипа, скорее всего, вдохновлялся клубами пара. Но каждый раз, как мимо хожу, глаз цепляется :)

Vaporia

Мимикрия ChatGPT
29 сентября 2024 ·

Коллеги вовсю экспериментируют с o1-preview от OpenAI: модель получилась по-настоящему интересной. Жаль, задачи для неё попадаются не так уж часто: с большинством повседневных прекрасно справляется и обычная 4o. Поиск ошибок в коде, анализ медицинских тестов на незнакомом языке, попытки вспомнить название книги, которую читал в детстве и едва помнишь завязку — я сходу и не вспомню, что ей не по зубам.

Каждый раз любопытно смотреть, как ИИ рассуждает, шутит и вообще, старается выглядеть как человек. Я бы сказал, что тест Тьюринга эта штука пока не пройдёт, но время от времени стреляет пугающе близко.

Морковка Кулаки Угараешь?

А вот ответ ниже прямо порадовал. Даже если оставить за скобками философию — Скайнет, похоже, отменяется! :) Впрочем, будущее из финала SOMA — пока, боюсь, нет.

Любовь

Мой первый подход к генеративкам
25 августа 2024 ·

Понадобилось по-быстрому наделать картинок для одного пет-проекта. Развернул первое, что под руку попалось — WaifuDiffusion (это такой клон StableDiffusion, но обученный на аниме и манге).

Запрос:

A dimly lit, empty classroom with faintly visible music notes on the chalkboard. A young woman with long blue hair and blue eyes, is standing behind the teacher's desk, packing her things into a small handbag. She looks tired and worried.

Результат:

Молодая женщина

Кажется, это отличный повод поговорить о том, как далеко вперед шагнули нейросети! Модель с порога раскусила задумку и предложила ввести в сюжет... Хм... Мудрого бородача? Или, возможно, намекнула, что я должен больше ценить неожиданные сюрпризы?

Думаю, WaifuDiffusion просто решила поднять мне настроение. Смех, говорят, продлевает жизнь. В любом случае, первую генерацию считаю успешной! Но над калибровкой явно придется поработать еще :)

Клементина запомнит это
9 августа 2024 ·

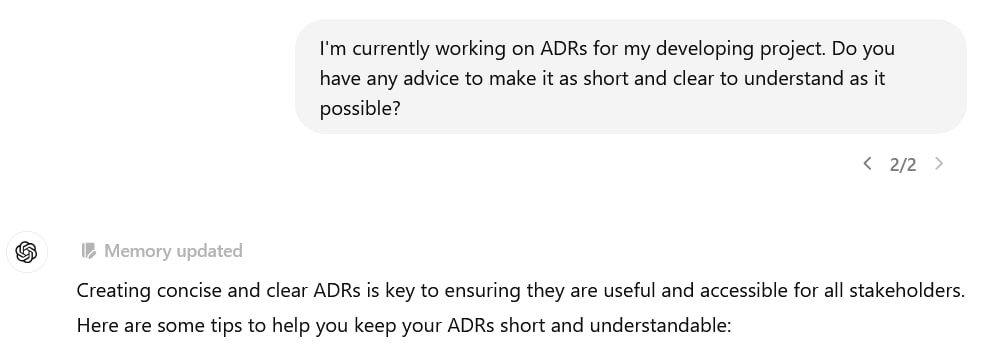
Когда ChatGPT запоминает какую-то деталь диалога на будущее, он рисует над своим ответом плашку "Memory updated". Типа, я понял:

Memory updated

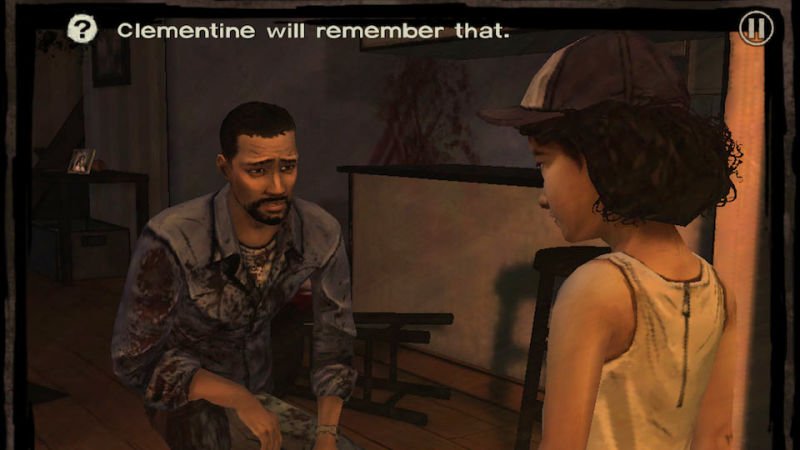
Каждый раз смешно: сразу вспоминается The Walking Dead и мем «Клементина запомнит это» :) В этой игре персонажи, окружающие протагониста, запоминали его решения и это оказывало влияние на их поведение. В том числе и Клементина — девочка, которую главный герой спасает в начале игры.

Клементина запомнит это

В игре эта механика была сделана, если честно, так себе, а вот ChatGPT и правда все запоминает. Внимание к деталям такое, что иногда приходится напоминать себе, что разговариваешь с языковой моделью, а не с необыкновенно участливым и очень эрудированным человеком.